услуга: Мобильная разработка
направление: Авто
Как мы экономим >100000 рублей в день на проверке состояния чистоты автомобиля с помощью Qwen3-VL:8B и Qwen3-VL:8B-Instruct

В этой статье я пошагово расскажу о том, как мы внедрили визуальную языковую модель. Перед нами стояла крайне важная задача: каждый день сотни инструкторов начинают свою рабочую смену, но прежде им необходимо пройти проверку состояния автомобиля. Дело в том, что в «Векторе» действуют очень строгие правила касательно допускаемых к работе автомобилей.
Если машина грязная, ее обязательно нужно помыть, и только после этого инструктор может приступить к работе. Раньше инструкторы отправляли фотографии своим руководителям на согласование. Это отнимало у руководителей массу времени, которое они могли бы потратить на более важные задачи. К тому же заявки на проверку накапливались, а иногда и вовсе терялись.
Поэтому нам понадобилось это автоматизировать.
После долгих тестов и обсуждений мы выбрали две модели Qwen: qwen3-vl:8b и qwen3-vl:8b-instruct. В теории пайплайн прост: инструктор фотографирует свою машину и отправляет снимок в наше приложение.
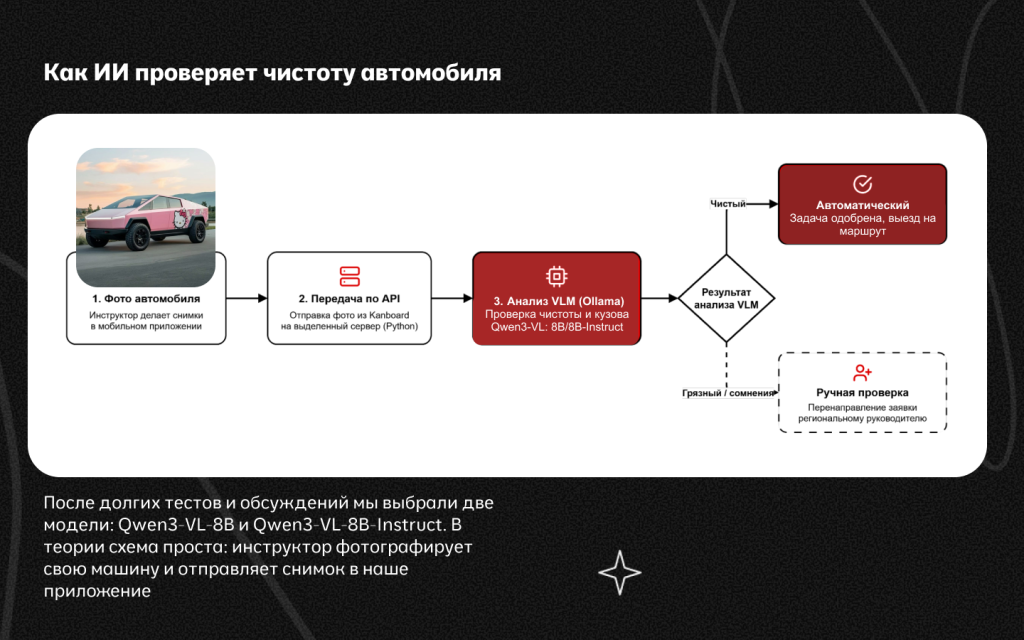
Оттуда приложение через API вызывает визуальную модель. Если модель уверена, что автомобиль чистый, инструктор получает «зеленый свет» и может начинать день. Если модель сомневается или видит, что машина грязная, она передает эту заявку руководителю, который принимает окончательное решение.
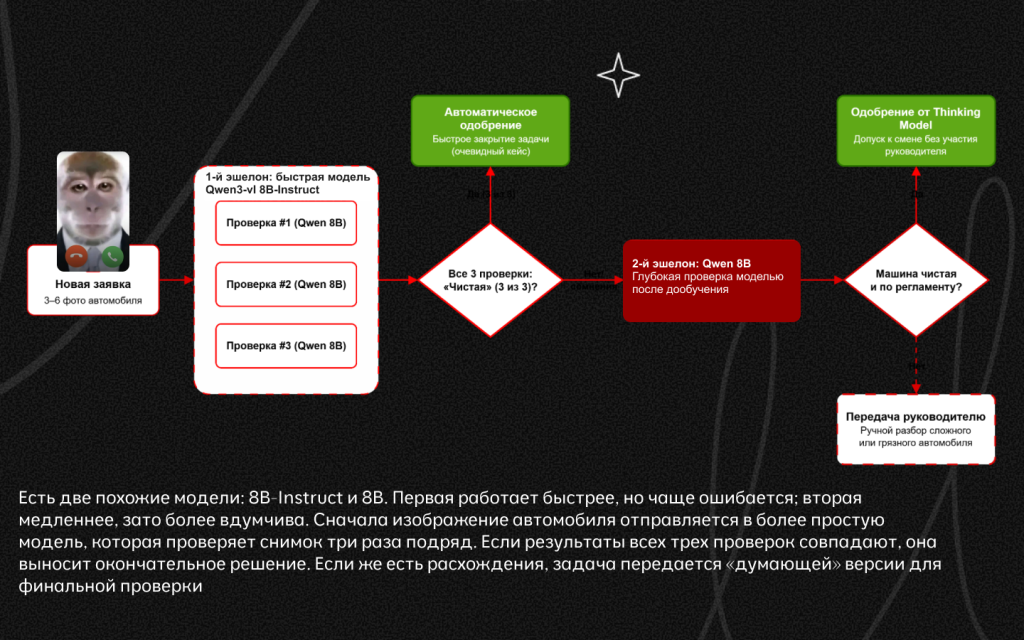
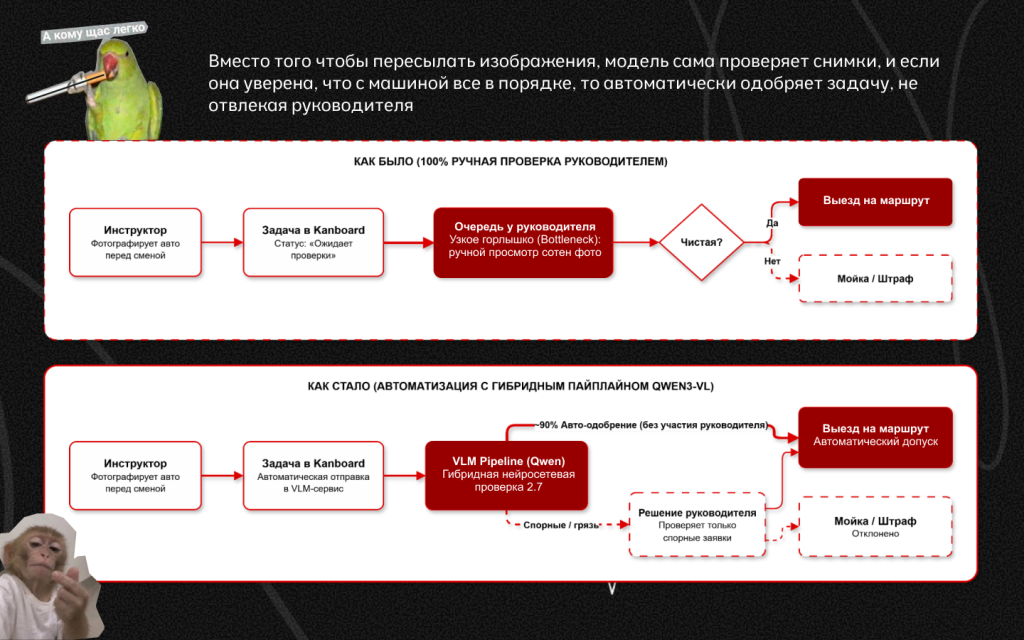
Хотя в некоторых случаях участие руководителя все еще требуется, это кардинально снижает его нагрузку. На практике же под капотом происходит гораздо больше. Как видите, у нас есть две похожие модели: 8B-instruct и 8B. Первая работает быстрее, но чаще ошибается; вторая медленнее, зато более вдумчива. Сначала изображение автомобиля отправляется в более простую модель, которая проверяет снимок три раза подряд. Если результаты всех трех проверок совпадают, модель выносит окончательное решение. Если же есть расхождения, задача передается «думающей» модели для финальной проверки.
ПОСТАНОВКА ЗАДАЧИ
Теперь давайте подробнее разберем, какую именно задачу мы решали. «Вектор» — это компания, специализирующаяся на услугах автоинструкторов. Каждый день тысячи инструкторов по всей стране готовятся к началу рабочего дня, обучая студентов азам вождения. Одно из главных достоинств «Вектора» как компании — это стремление к совершенству. Автомобили должны быть в идеальном состоянии, прежде чем выехать на дорогу.
Отсюда возникает проблема: как это контролировать и обеспечивать? Изначально это была задача руководителей. Перед началом смены каждый инструктор делал несколько фотографий своего автомобиля и прикреплял их к специальной задаче, автоматически создаваемой в корпоративном приложении. Затем региональный руководитель должен был просматривать отчеты каждого своего инструктора, проверяя, находится ли машина у каждого из них в надлежащем состоянии.
Скажем прямо, это действительно непростая задача, особенно если учесть, что у самого руководителя хватает своей работы, а ему приходится в спешке проверять все заявки до официального начала рабочего дня. Поэтому мы решили: нужно это автоматизировать.
Организация задачи довольно проста. В «Векторе» используется специальное приложение на базе Kanboard, где каждый день каждому инструктору приходит задача «Внешний вид». К ней он прикрепляет фотографии, сделанные на телефон, и отправляет их руководителю на проверку. Задача либо одобряется, и инструктор выезжает на маршрут, либо отклоняется — тогда ему приходится либо мыть машину, либо он лишается возможности работать в этот день, что сопровождается вычетом из заработной платы. И вот тут вступает в дело автоматизация.
Вместо того чтобы пересылать изображения, модель сама проверяет снимки, и если она уверена, что с машиной все в порядке, то автоматически одобряет задачу, не отвлекая руководителя.
ВЫБОР МОДЕЛИ
Выбор модели был одним из самых сложных этапов разработки: необходимо было подобрать модель, которая одновременно подходит нам по качеству и точности (мы не можем допустить, чтобы модель выпустила на дорогу грязную машину). Но и сценарий, при котором неуверенная модель будет делать множество false positive реакций, нам тоже не подходит, так как лишит смысла весь процесс автоматизации. Также модель должна быть легковесной и быстрой, чтобы она могла разбирать входящие запросы эффективно. Модели от Qwen раньше использовались мной в разработке, и поэтому мой выбор сразу пал на них. К тому же их визуальные модели действительно отличаются высоким качеством.
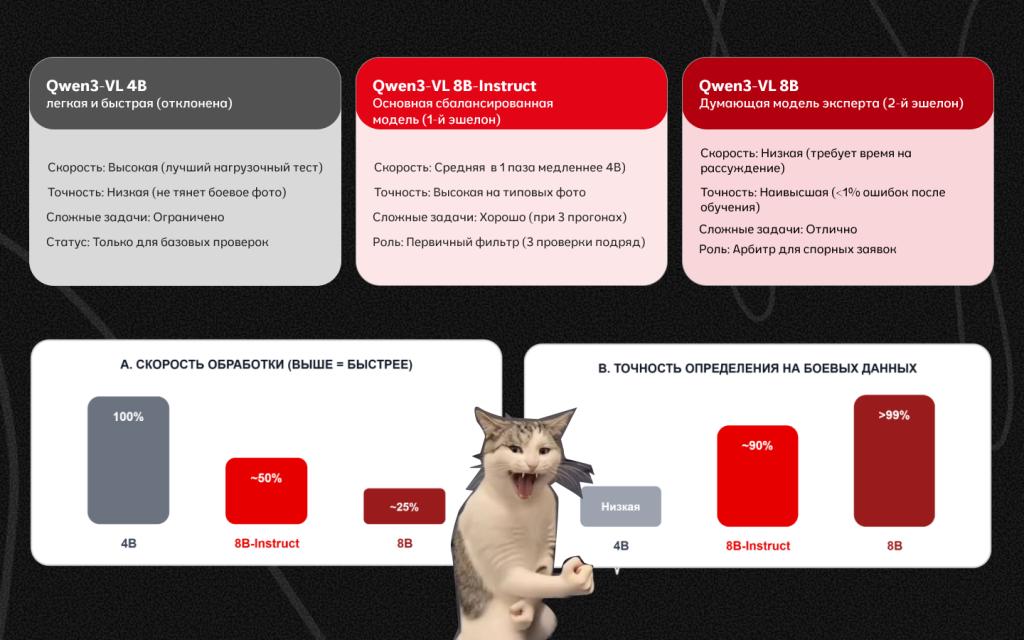
Изначально выбор пал на модель 4b — это быстрая, легковесная модель, которая хорошо проходила легкие тесты. Показывала, что машина есть в кадре, и прочее. Но при переходе на реальные тесты на боевых данных стало понятно, что модель не справляется. Также она прекрасно прошла нагрузочные тесты. Тогда был сделан выбор перейти на модель мощнее — 8b. Мы сразу увидели скачок в качестве: там, где раньше модель была не уверена, 8-модель четко определяла качество машины.
Правда, это привело к росту длины запроса, и нагрузочные тесты, симулирующие реальную нагрузку, стали хуже в 2 раза. После некоторого рассуждения было принято решение, что снижение скорости стоит повышенной точности. Но даже с 8-моделью не всегда справлялась с поставленной задачей: было много кейсов, слишком сложных для простой модели. На выручку пришла думающая модель. Простыми словами, такая модель требует больше времени на ответ, но он точнее, так как модель «обдумывает» его.
ПЕРВАЯ РЕАЛИЗАЦИЯ И ПОСТРОЕНИЕ РАБОЧЕГО ПАЙПЛАЙНА
Правда, использовать ее для всех задач — это слишком, нет смысла использовать думающую модель для очевидных случаев. К счастью, нет необходимости выбирать: при использовании гибридного подхода изначально каждая задача передается легкой модели, которая обрабатывает фото и дает ответ «добро» или «нет», и делает так 3 раза. Если все 3 раза модель уверена, что машина чистая, то задача закроется; если хотя бы раз модель посчитала, что машина не чистая, или модель попросту не уверена, задача передается думающей модели. Которая принимает финальное решение: отправить машину на дорогу или менеджеру на финальную проверку.
Это привело к увеличению точности. На данном этапе тесты показывали ~10% погрешности на тесте из 9000 изображений, собранных из реальных боевых задач. Но, как я говорил выше, идеология «Вектора» — это идеал. И 10% ошибок недостаточно. Переход на более производительную модель оказался нерентабельным: нагрузочные тесты, которые текущая модель проходила за 10 минут, модель тяжелее проходит за 40 минут. Тогда мы поняли, что пришло время использовать козырь любой модели — обучение. Обучение состояло из двух этапов: были сформированы списки из множества реальных боевых примеров. Каждое фото было оценено по 3 критериям: чистота, комплектация и состояние. Затем эти данные были переданы в саму модель для обучения. Результат превзошел все ожидания. Имея реальные примеры, на которые можно положиться, модель начала точнее распознавать машины; в результате порог ошибок был снижен с 10% до <1%
ТЕСТИРОВАНИЕ
Отдельно я хочу выделить процесс тестирования так-как он являлся краеугольным камнем процесса выбора модели, по сути была разработано 3 вида тестов. Первичный тест, Нагрузочный тест и Тест на точность.
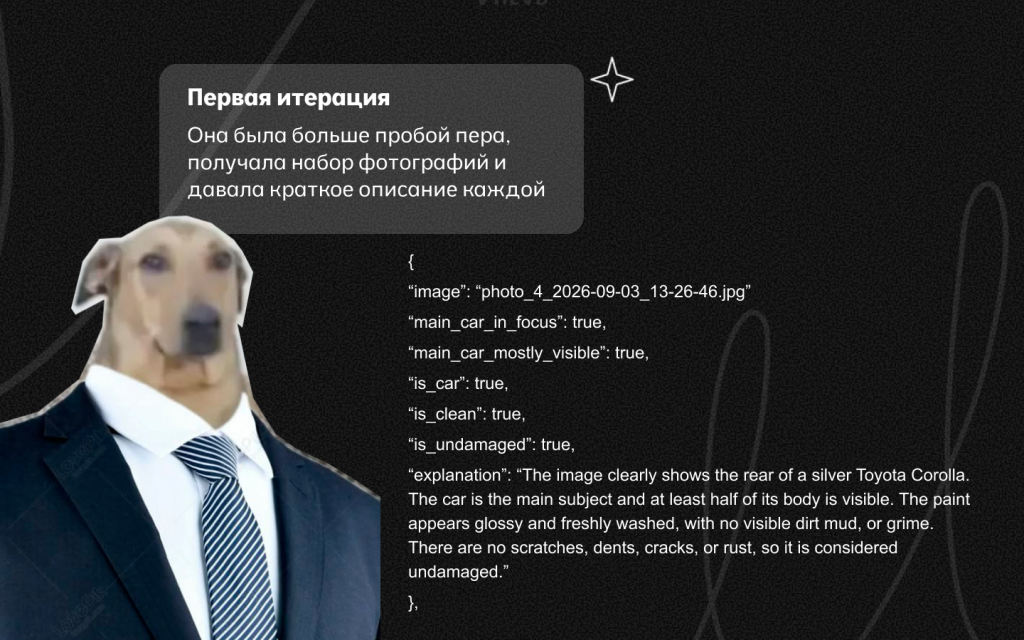
Первичный тест был больше пробой пера, он получал набор фотографий и давал краткое описание каждой
Мы использовали его для первичной оценки способностей модели.
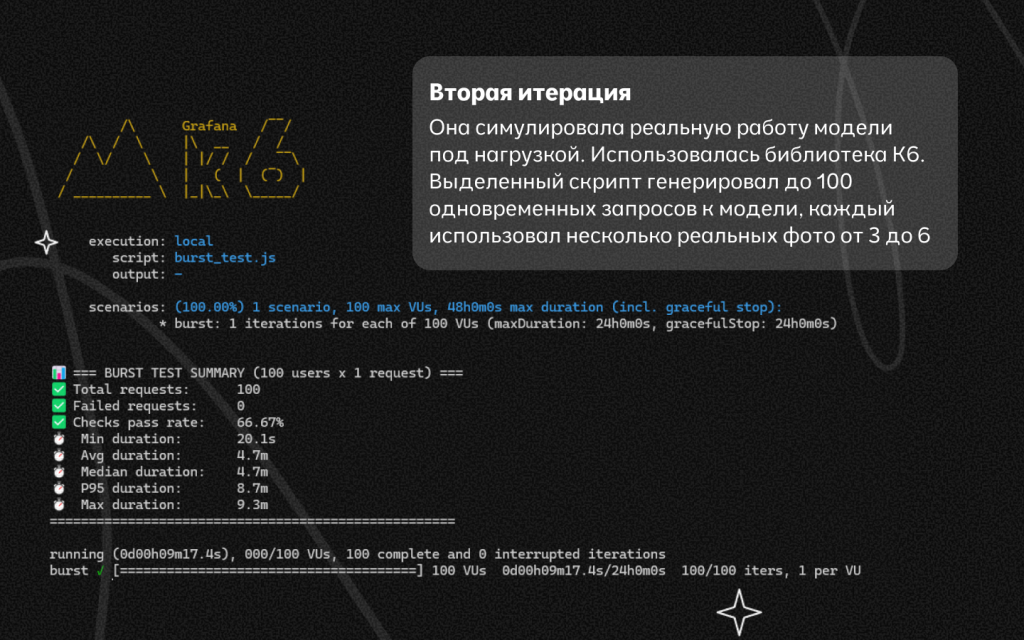
Нагрузочный тест уже интереснее. Он симулирует реальную работу модели под нагрузкой. Использовалась библиотека К6. Тест происходил следующим образом, выделенный скрипт генерировал до 100 одновременных запросов к модели каждый использовал несколько реальных, боевых фото от 3 до 6.
Затем Тест замерял данные, и мы получали результат. 100 запросов было выбрано не просто так это пиковые значения, когда в каждом часовом поясе инструктора готовят свои машины.
Тест на точность самый интересный и самый важный. Он работает по следующему принципу была создана выборка реальных кейсов реальных фото, которые уже изначально определены экспертами по 4 категориям Идеальные, грязные и битые, Чистые и битые, битые и грязные.
В итоге было выбрано 9000 фото. Потом они по очереди отправлялись модели чтобы она сама определяла их категорию, после чего мы оценивали насколько точно она определяла категорию.
Финальная реализация и настройка сервера
И так мы выбрали модель и даже настроили workflow теперь финальный этап нашего путешествия, необходимо собрать все что мы сделали в единый рабочий процесс.
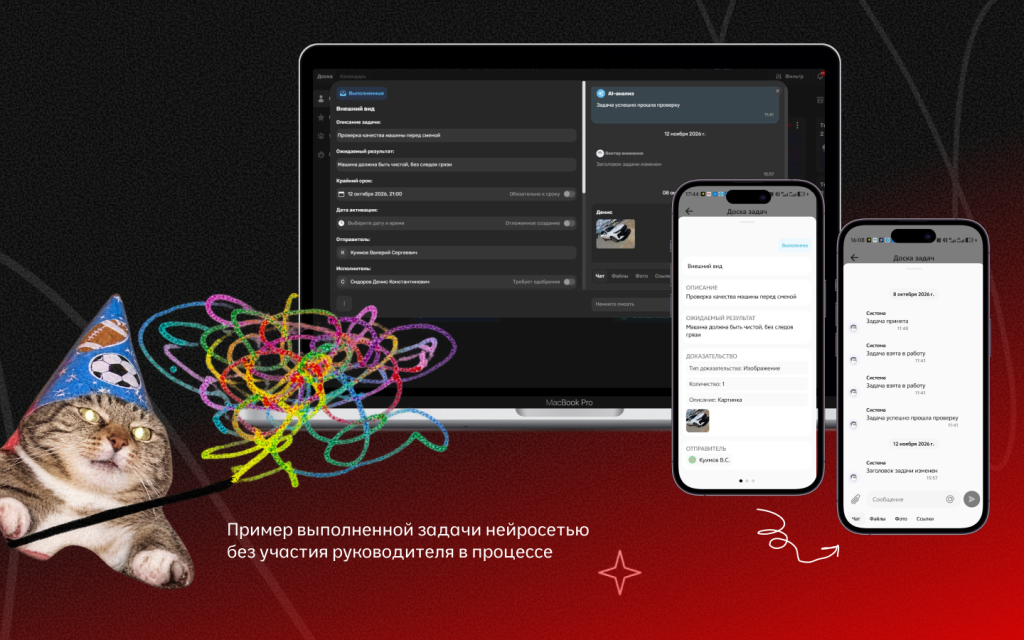
Еще во время первичных тестов было принято решение развернуть модель на выделенном физическом сервере. Модели были установлены через сервис Ollama, необходимые скрипты написаны на языке python стандартная практика, Серевер работает просто он получает http запросы от основного приложения, когда инструктор отправляет машину на проверку, после чего перенаправляет ее в стэк модели, где она обрабатывается.
По результатам теста было видно что при максимальной нагрузке обработкка может занимать до 10 минут, в этом случае задача помечатся как отложенная и проверяется
Заключение
Теперь главный вопрос: стоило ли оно того? Ответ однозначно — да.
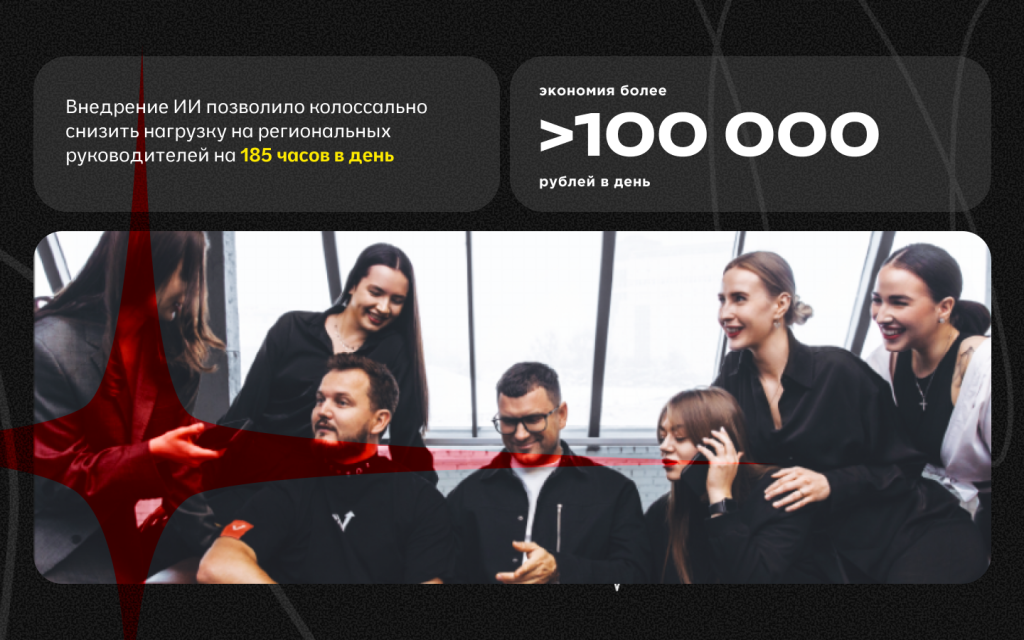
Внедрение визуальной языковой модели позволило колоссально снизить рутинную нагрузку на региональных руководителей. Теперь вместо того, чтобы каждое утро в спешке просматривать сотни одинаковых фотографий, менеджеры могут фокусироваться на по-настоящему важных задачах: развитии филиалов, работе с клиентами и повышении качества сервиса.
Кроме того, мы убедились в гибкости и масштабируемости этого решения. Уже сейчас мы планируем интегрировать подобный гибридный подход в другие бизнес-процессы компании.
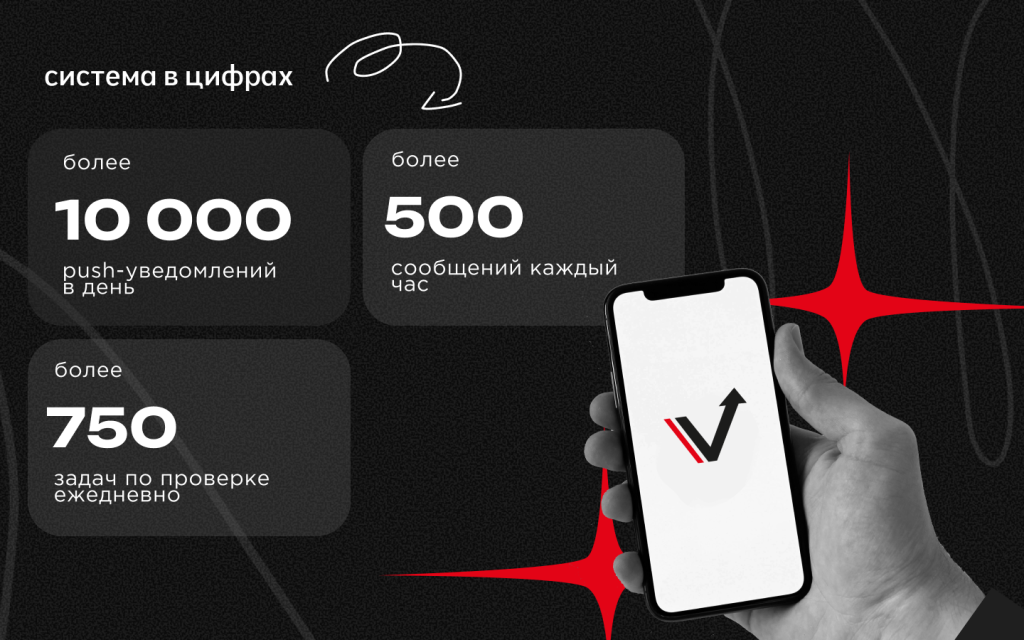
Результат в цифрах

Проконсультируем по всем вопросам